Normalización vs desnormalización en bases SaaS
DevOps
Guía práctica para elegir entre normalizar o desnormalizar en SaaS: prioriza consistencia y desnormaliza solo si las lecturas lo exigen.

Si tengo que decirlo en una frase: en un SaaS, yo normalizaría primero y solo desnormalizaría cuando las métricas de lectura me frenen de verdad.
Así de simple. La elección no va de teoría ni de “me gusta más este modelo”. Va de qué problema intento resolver hoy:
Normalización: menos datos repetidos, menos fallos al actualizar, más control en facturación, permisos y suscripciones.
Desnormalización: lecturas más cortas, menos joins en pantallas pesadas, pero más trabajo al escribir y al sincronizar copias.
Modelo mixto: base normalizada para datos críticos y vistas, resúmenes o cachés para paneles y analítica.
Si mi producto está en una fase temprana, suelo priorizar consistencia y orden. Si ya tengo volumen y veo consultas lentas de forma medible, empiezo a duplicar o precalcular solo lo que aporta valor. En muchos SaaS, el patrón que mejor aguanta el paso del tiempo es ese: núcleo limpio + lecturas preparadas.
Qué comparo para decidir:
coste de lectura
coste de escritura
riesgo de inconsistencias
carga de mantenimiento
fase del producto
tipo de funcionalidad
Regla corta: si un dato afecta a cobros, acceso o auditoría, yo no jugaría con copias sin control. Si un panel se consulta cientos o miles de veces al día, ahí sí puede compensar tener datos ya preparados.
Normalización y Desnormalización de Bases de Datos
Quick Comparison
Criterio | Normalización | Desnormalización |
|---|---|---|
Dato repetido | Poco | Sí, a propósito |
Lectura | Puede caer con muchos joins | Suele ir mejor |
Escritura | Más simple | Más delicada |
Consistencia | Más fácil de mantener | Más riesgo si falla la sincronización |
Uso típico | Facturación, RBAC, suscripciones | Paneles, métricas, resúmenes |
Momento de uso | Inicio y núcleo transaccional | Cuando hay cuello de botella medido |
Un dato práctico: en muchos productos, el 80 % de la carga de lectura acaba viniendo de unas pocas pantallas, como dashboards, listados y métricas. Por eso no hace falta tocar todo el esquema. A menudo basta con desnormalizar ese 20 % de consultas que más castiga la base.
Con esa idea en mente, el artículo baja a tierra cuándo conviene cada enfoque, qué cambia en un SaaS multitenant y dónde compensa usar un modelo híbrido.
Esquemas normalizados en SaaS: estructura, escrituras y mantenimiento
En un SaaS típico, la normalización separa tenants, users, memberships, subscriptions, invoices y audit_events en tablas distintas, unidas por claves foráneas. Cada entidad tiene una sola fuente de verdad. ¿El resultado? Menos duplicidad y menos coste de mantenimiento. Donde más brilla este enfoque es en la escritura y en el mantenimiento; donde suele apretar el zapato es en la lectura.
Cómo la normalización elimina duplicados y anomalías
La idea central es simple: cada dato debe tener un único lugar de referencia. Si el nombre de un cliente vive en tenants, no hace falta repetirlo en invoices ni en subscriptions. Cuando ese dato cambia, basta con actualizar un registro.
Sin normalización, la cosa se complica. El mismo cambio puede obligarte a tocar varias tablas, con el riesgo de dejar alguna sin actualizar y acabar con datos inconsistentes. Y ahí empiezan los problemas: una factura con un nombre, una suscripción con otro, y el soporte intentando atar cabos.
Esto importa mucho en datos como cliente, plan activo o factura: la base de cualquier SaaS multitenant. Así evitas duplicados y anomalías desde el propio diseño, no cuando ya han salido a la luz.
Por qué funciona bien en escrituras
Los SaaS transaccionales están escribiendo datos todo el rato: altas de usuarios, cambios de plan, emisión de facturas o eventos de auditoría. En un esquema normalizado, cada escritura toca solo las tablas que hacen falta. Eso hace que las transacciones sean más simples y reduce el riesgo de inconsistencias.
Por ejemplo, si un usuario cambia de plan, normalmente basta con actualizar su registro en subscriptions. No hace falta ir arrastrando ese cambio por medio esquema. Es una forma bastante limpia de trabajar.
También ayuda en auditoría y depuración, porque los eventos apuntan a datos canónicos. Cuando toca revisar qué pasó, tener una fuente única para cada entidad ahorra tiempo y dolores de cabeza. El atasco llega cuando esas lecturas empiezan a pedir demasiados joins.
Cuándo las lecturas empiezan a ralentizarse
El cuello de botella no está en la normalización por sí sola, sino en cómo crecen las consultas complejas cuando el producto escala. Al principio todo va bien. Luego llegan más datos, más relaciones y más pantallas que necesitan mezclar información de varias tablas a la vez.
Antes de tocar el esquema, conviene ir por orden: revisa la consulta, ajusta índices y mide el impacto. Muchas veces el problema no está en el modelo, sino en una query mal planteada o en índices que no acompañan. Si aun así los índices no bastan, entonces sí tiene sentido valorar la desnormalización.
Esquemas desnormalizados en SaaS: velocidad de lectura, complejidad y compromisos
Cuando los índices se quedan cortos, la desnormalización deja de sonar mal y pasa a ser una herramienta útil. Hablamos de una decisión deliberada: duplicar datos o dejar ciertos valores precalculados para acelerar lecturas muy concretas, sobre todo cuando una pantalla necesita tirar de varias tablas al mismo tiempo.
Dónde mejora el rendimiento del producto
En un SaaS, muchas de las consultas que más se repiten mezclan datos de varias tablas. Pasa en listados, paneles, métricas de uso, facturación o permisos. Si guardas un valor ya calculado en una tabla resumen o en una vista materializada, te ahorras repetir ese cálculo en cada petición. El resultado es simple: baja la latencia de lectura.
Esto suele verse en patrones de diseño bastante claros:
Contadores precalculados
Tablas resumen
Vistas materializadas
Tiene sentido. Si una misma consulta se ejecuta una y otra vez, recalcularlo todo cada vez acaba saliendo caro.
Qué le cuesta a las escrituras y a la consistencia
Claro que no sale gratis. Cada lectura más rápida mueve trabajo hacia la escritura. Lees antes, sí, pero escribir se vuelve más delicado. Si una actualización falla o llega tarde, los datos quedan desincronizados.
En esquemas multitenant, el problema crece. Hay más piezas en juego y más cosas que coordinar y revisar para que todo siga cuadrando.
Por qué suele ser una decisión tardía
Desnormalizar demasiado pronto mete complejidad antes de saber si de verdad merece la pena. Por eso suele ser una decisión que llega más tarde, cuando las métricas ya enseñan un cuello de botella real en lectura.
La idea de fondo es bastante directa: solo compensa cuando la ganancia en velocidad justifica el coste extra en complejidad.
Normalización vs desnormalización: comparativa directa para SaaS
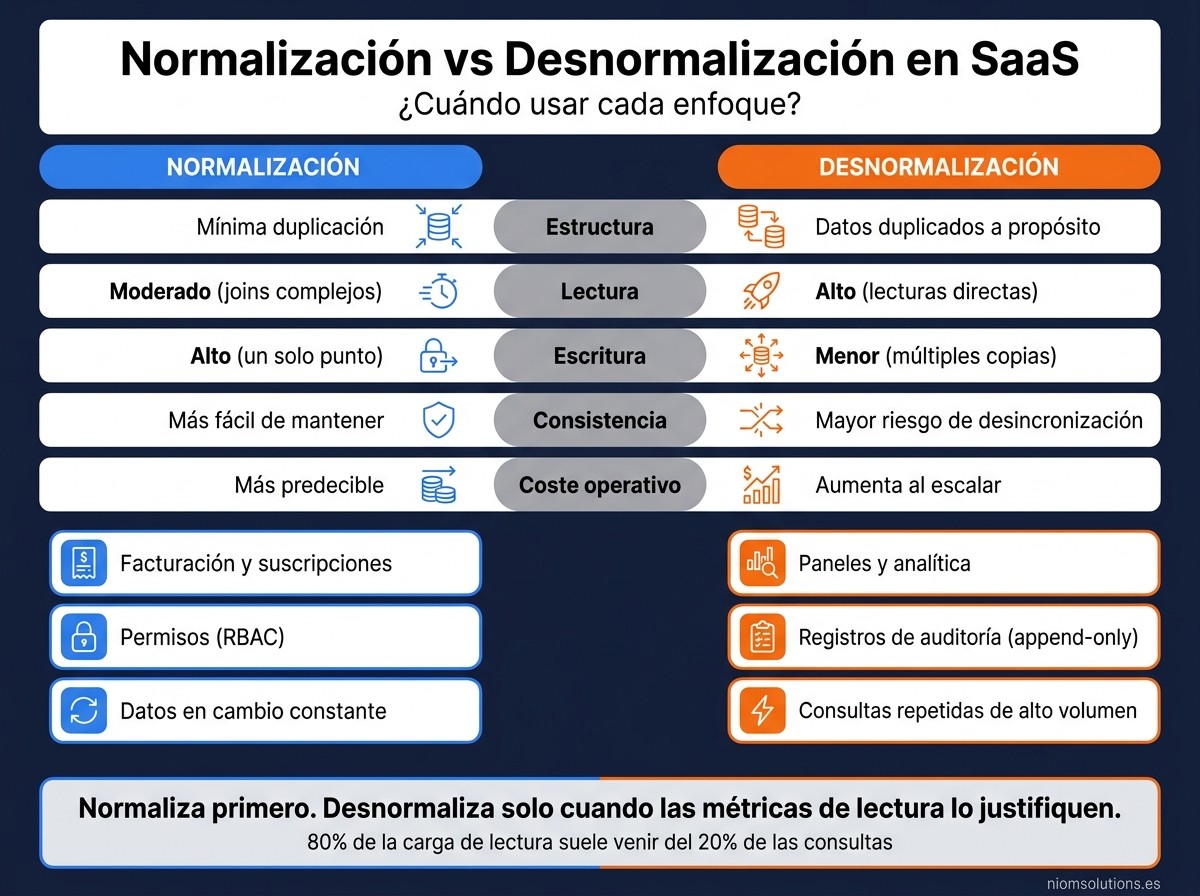
Normalización vs Desnormalización en SaaS: Guía de Decisión
Después de ver los puntos fuertes y flojos de cada enfoque por separado, toca compararlos cara a cara. Aquí la clave no está solo en la teoría. Está en la carga de trabajo y en el momento en el que se encuentra el producto.
Al final, la decisión suele bajar a cuatro costes: lectura, escritura, consistencia y mantenimiento.
Tabla comparativa: estructura, rendimiento y mantenimiento
Dimensión | Normalizado | Desnormalizado |
|---|---|---|
Estructura del esquema | Tablas separadas, con menor duplicación | Datos duplicados a propósito para leer más rápido |
Rendimiento de lectura | Moderado; puede bajar cuando hay JOINs complejos | Alto; suele permitir lecturas directas |
Rendimiento de escritura | Alto; las actualizaciones suelen hacerse en un solo punto | Menor; cada cambio puede exigir actualizar varias copias del dato |
Complejidad de consultas | Más alta en consultas con muchas relaciones, aunque la sincronización añade carga | Más baja en lecturas simples |
Coste operativo | Más predecible a largo plazo | Más costoso al escalar |
Visto de forma simple: normalizar suele dar más control al escribir y mantener los datos, mientras que desnormalizar suele ganar terreno cuando lo que manda es leer rápido. El problema es que ese ahorro en lectura casi siempre aparece por otro lado, sobre todo en sincronización y mantenimiento.
Tabla comparativa: encaje por funcionalidad
Cada funcionalidad empuja en una dirección distinta. No todos los módulos de un SaaS piden la misma velocidad ni el mismo nivel de integridad.
Funcionalidad | Recomendación | Motivo |
|---|---|---|
Facturación y suscripciones | Normalizado | Requiere integridad ACID estricta y consistencia de datos. |
Permisos (RBAC) | Normalizado | Tiene relaciones complejas y es un dato crítico para la seguridad. |
Registros de auditoría | Desnormalizado | Tiene mucho volumen de escritura y suele ser de tipo append-only. |
Paneles y analítica | Desnormalizado | Prioriza la velocidad de lectura y los datos preagregados. |
Catálogo de producto | Híbrido | Suele tener atributos flexibles y mucha frecuencia de lectura. |
Aquí se ve bastante claro. Facturación, suscripciones y RBAC no son buen sitio para jugar con incoherencias. En cambio, en paneles, analítica o logs de auditoría, muchas veces compensa tener los datos preparados para consulta, aunque eso implique duplicación.
Tabla comparativa: encaje por fase de producto
La fase del producto también cambia la decisión. No es lo mismo arrancar un MVP que aguantar una base de usuarios en crecimiento.
Fase del producto | Normalizado | Desnormalizado |
|---|---|---|
MVP / prototipado | Reduce riesgo de inconsistencias desde el inicio | Permite iterar más rápido con menos estructura |
Crecimiento / escala | Mantiene la consistencia cuando el volumen aumenta | Compensa cuando los cuellos de botella en lectura ya son medibles |
Dicho de otra forma: al principio puede pesar más la velocidad para moverse y probar cosas. Más adelante, cuando el volumen sube, ya no basta con “que funcione”. Empieza a importar cuánto cuesta mantenerlo sin que cada cambio rompa algo.
Modelo híbrido: núcleo normalizado con vistas desnormalizadas
En la práctica, la mayoría de SaaS terminan mezclando ambos enfoques. Mantienen un núcleo normalizado para los datos críticos y crean vistas desnormalizadas para las lecturas repetidas.
Es una solución bastante lógica. Mantienes la consistencia donde más importa y, al mismo tiempo, bajas la latencia en las consultas que más se repiten, sin poner en riesgo la integridad del conjunto.
Conclusión: cómo elegir el enfoque correcto para tu SaaS hoy
Después de comparar estructura, lectura, escritura y mantenimiento, la idea central es simple: la elección depende de la fase del producto y del coste que estés dispuesto a asumir en lectura, escritura y mantenimiento.
Normaliza cuando la consistencia sea la prioridad y el esquema aún esté cambiando. Si el modelo sigue en movimiento, un esquema normalizado ayuda a mantener el equilibrio entre integridad y velocidad de lectura. Además, reduce el riesgo de anomalías en datos críticos del producto.
Cuando esa base se quede corta, cambia el enfoque: desnormaliza solo cuando las métricas indiquen que la lectura está frenando el producto y el coste de sincronizar datos sea asumible. Lo más sensato suele ser empezar con un núcleo transaccional limpio y sumar desnormalización solo en los puntos donde los datos la justifiquen.
A partir de ahí, el siguiente paso es diseñar únicamente las vistas de lectura desnormalizadas o las cachés que aporten valor de verdad. Si estás construyendo un SaaS y necesitas definir el esquema desde el principio, en Niom Solutions trabajamos con equipos que quieren lanzar productos bien estructurados, sin deuda técnica innecesaria.
FAQs
¿Cómo sé si mis JOINs son ya un problema real?
Tus JOINs se convierten en un problema de verdad cuando el rendimiento de las consultas cae de forma clara. ¿El efecto? La experiencia de usuario se resiente y los costes de infraestructura suben.
Esto suele aparecer al escalar la base de datos. En ese punto, combinar varias tablas en tiempo real puede pedir demasiados recursos. Si ves latencias altas en consultas frecuentes, toca revisar la complejidad de lectura y plantearse si conviene aplicar desnormalización o crear índices bien pensados.
¿Qué datos no deberías desnormalizar nunca en un SaaS?
En un SaaS, no conviene desnormalizar datos sensibles cuando necesitan un control de integridad muy estricto o pueden dar problemas serios si se filtran.
Mejor evita desnormalizar:
datos personales identificables
información financiera, como pagos
datos de nivel alto o muy alto según el RGPD, como biométricos, de salud o creencias
Y hay otra regla simple que te puede ahorrar muchos disgustos: no metas este tipo de datos en estructuras legibles por el cliente, como los payloads de JWT.
¿Cómo implanto un modelo híbrido sin complicar el sistema?
Combina cookies de sesión en el navegador y JWT solo cuando te den una ventaja clara. La idea es simple: no uses JWT por costumbre, úsalo cuando tenga sentido.
Guarda el JWT en una cookie con HttpOnly y Secure. Además, aplica SameSite=Lax o SameSite=Strict para reducir el riesgo de CSRF. Y ojo con el tiempo de vida: mejor corto, de 10 a 15 minutos.
También hay una parte que no conviene pasar por alto: valida siempre los claims iss, aud, exp y alg, junto con la firma. Si no haces esa comprobación, el token deja de ser una capa de control y se convierte en un problema.
Para acciones críticas, como cambios de contraseña o pagos, deja la verificación completa en el servidor. En cambio, para llamadas frecuentes a la API, el uso de JWT puede encajar mejor y quitar fricción.